Datenblatt, Pflegehinweise, Größentabelle, Preisliste: In vielen Shops und auf vielen Unternehmensseiten liegen genau die Inhalte, die Kund:innen vor dem Kauf suchen, nur als PDF vor. Meist, weil der Hersteller sie so liefert oder weil die Grafik sie so gestaltet hat.
Google kann PDFs lesen, und sie können sogar in KI-Antworten auftauchen. Trotzdem ist das PDF für mich immer die letzte Lösung. Ich zeige dir, was Google mit deinen PDFs macht, warum HTML für deine Kund:innen die bessere Wahl ist und wie du die Daten aus den PDFs herausbekommst, ohne dass jemand wochenlang abtippt.
Was macht Google mit deinen PDFs?
Google führt PDF in seiner Liste der Dateitypen, die es indexieren kann. Indexieren heißt, eine Datei in die Datenbank aufzunehmen, aus der Google seine Suchergebnisse zusammenstellt. PDFs gelten dort als kodierte Formate, also als Dateien, aus denen ein eigenes Programm erst den lesbaren Text herausholen muss.1
In welcher Reihenfolge verarbeitet Google ein PDF?
Martin Splitt von Google hat im Oktober 2026 im Google-Podcast „Search Off the Record“ beschrieben, wie das abläuft.2 Zusammen mit der Google-Dokumentation ergibt sich diese Reihenfolge:
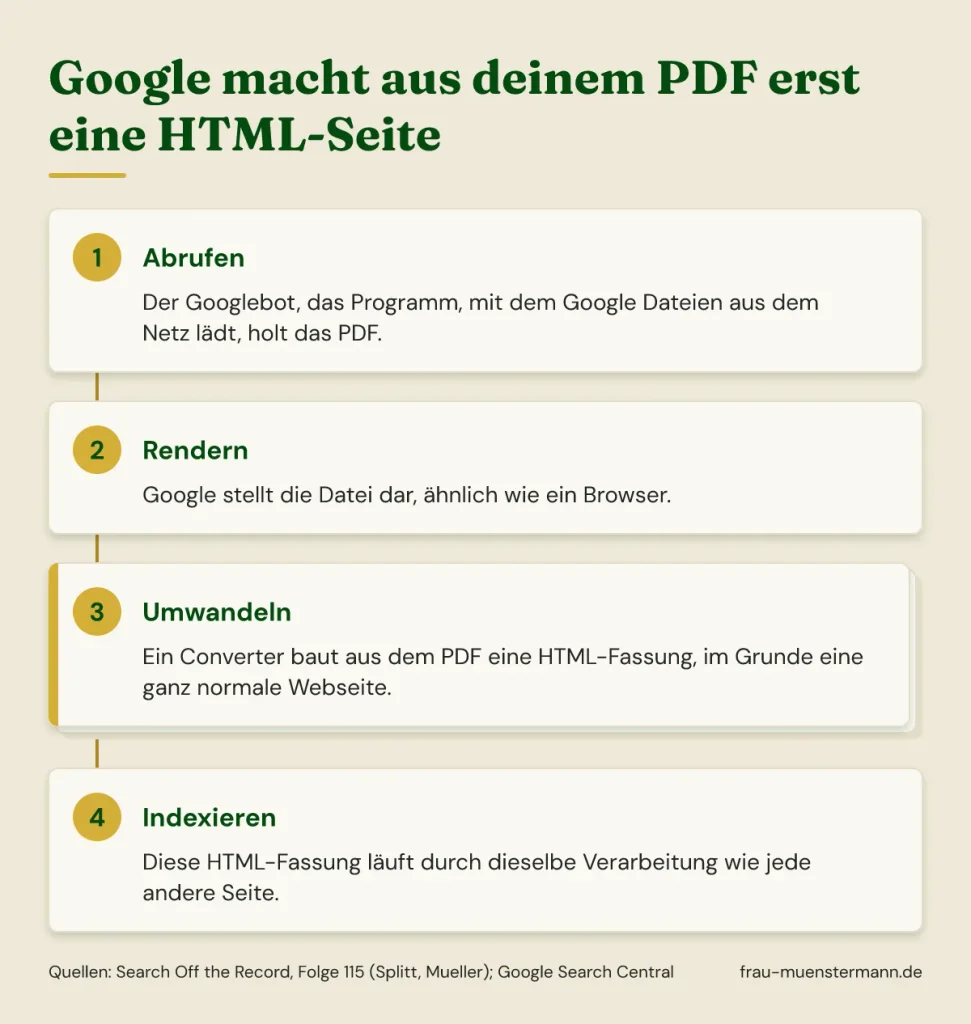
- Abrufen: Der Googlebot, also das Programm, mit dem Google Dateien aus dem Netz lädt, holt das PDF. Er liest die ersten 64 MB, bei HTML-Seiten sind es die ersten 2 MB. Was darüber hinausgeht, wird abgeschnitten und nicht berücksichtigt.3
- Rendern: Google stellt die Datei dar, ähnlich wie ein Browser.
- Umwandeln: Direkt danach baut ein sogenannter Converter aus dem PDF eine HTML-Fassung, im Grunde eine ganz normale Webseite.2
- Indexieren: Diese HTML-Fassung läuft durch dieselbe Verarbeitung wie jede andere Seite.
Das 64-MB-Limit greift also auf die rohe Datei, bevor umgewandelt wird. Gezählt wird alles, was im PDF steckt, auch Bilder und eingebettete Schriften. Ob für die umgewandelte HTML-Fassung noch eine eigene Grenze gilt, weiß Splitt selbst nicht genau, er hält es für wahrscheinlich.2 Ich halte das für eine logische Vermutung, belegt ist es nicht.
Für normale Shop-PDFs spielt die Grenze praktisch keine Rolle. Google nennt zudem ungern feste Zahlen, weil sich die Werte ändern können.2
Ein Argument steckt für mich trotzdem in diesem Ablauf. Jedes PDF ist für Google ein zusätzlicher Arbeitsschritt, und bei den Millionen Dokumenten im Netz summiert sich jeder kleine Aufwand. Google sagt zwar ausdrücklich, dass es nach der Umwandlung keine Rolle spielt, ob eine Seite einmal ein PDF war.2
Ich würde trotzdem jedem raten, das einmal aus Googles Sicht durchzudenken. Wer so viele Dokumente verarbeitet wie Google, hat jeden Grund, an jedem Arbeitsschritt zu sparen. Und was Google sagt, ist nicht immer alles, was Google tut. Einen Beleg für einen Rankingnachteil gibt es nicht, aber ich biete Google lieber gleich das Format an, mit dem es am Ende ohnehin arbeitet.
Welche PDFs kann Google nicht lesen?
Das größte Problem sind PDFs, deren Seiten nur aus Bildern bestehen. Das passiert bei eingescannten Dokumenten oder wenn ein Programm die Seiten beim Export als Bild speichert. Google sieht dann keinen Text, und auch Screenreader, also Vorleseprogramme für blinde und sehbehinderte Menschen, kommen nicht an den Inhalt. OCR, die automatische Texterkennung aus Bildern, kann helfen, verlassen kannst du dich darauf aber nicht.2
Ob dein PDF lesbar ist, prüfst du in einer Minute. Öffne es, markiere alles mit Strg+A (am Mac Cmd+A), kopiere es und füge es in eine leere Textdatei ein. Erscheint dort der Text, kann Google ihn auch lesen.2 Bleibt die Datei leer, hast du ein Bild-PDF.
Die zweite Hürde ist ein Passwortschutz. Verschlüsselte oder passwortgeschützte PDFs kann Google nicht indexieren.4
Erscheinen PDFs in KI-Antworten?
Bei Google ja. Weil ein PDF intern zur normalen HTML-Seite wird, kann es genauso in den KI-Übersichten (AI Overviews) und im KI-Modus (AI Mode) der Google-Suche auftauchen wie jede andere Seite.2
Für ChatGPT, Perplexity und andere KI-Suchen gibt es dazu keine offizielle Dokumentation. Eine Studie der University of Toronto vom Oktober 2026 liefert aber einen Hinweis. Die Forscher haben Antworten von ChatGPT, Gemini und Perplexity mit Websuche ausgewertet, und von den gut 39.000 zitierten Adressen im Hauptdatensatz waren 3,1 Prozent PDFs.5
Die Studie hat allerdings klare Grenzen. Sie behandelt nur ein einziges Thema (Glasfaser-Internet in den USA), trennt nicht nach Plattform und ist noch nicht von anderen Fachleuten begutachtet. Ob ein PDF in KI-Antworten besser oder schlechter abschneidet als dieselbe Information als Webseite, sagt sie nicht. Belegt ist damit nur, dass auch andere KI-Systeme PDFs zitieren.
John Mueller von Google geht davon aus, dass KI-Anbieter PDFs auch zum Training nutzen und zum sogenannten Grounding, also um Antworten mit Quellen abzusichern.2 Splitt fasst es im Podcast so zusammen: „Good SEO is good GEO.“2 GEO steht für Generative Engine Optimization, die Optimierung für KI-Antworten.
Ich mache deshalb für KI-Antworten mit PDFs nichts anders als für die normale Suche. Ein PDF sperrt dich nicht aus, aber es bringt dir dort auch nichts, was eine Webseite nicht genauso kann. Ob dein PDF tatsächlich in KI-Antworten auftaucht, lässt sich aus meiner Sicht ohnehin nicht zuverlässig messen, weil dieselbe Frage nicht jedes Mal dieselbe Antwort liefert.
Stell wichtige Inhalte als HTML bereit
Dass Google PDFs lesen kann, heißt noch lange nicht, dass sie für deine Kund:innen funktionieren. Die meisten Gründe gegen das PDF haben weniger mit Google zu tun als mit den Menschen, die in deinem Shop etwas suchen.
Warum gehören Produktdaten auf die Produktseite?
In vielen Hersteller-PDFs stecken genau die Angaben, die Kund:innen für ihre Kaufentscheidung brauchen: Maße, Gewicht, Material, Farbe. Ich glaube nicht, dass ein Produkt gut ranken kann, wenn diese Informationen nur im angehängten PDF stehen.
Einen Teil davon musst du ohnehin pflegen, wenn deine Produkte in Google Shopping erscheinen sollen, also bei den Produktanzeigen und Produkteinträgen in der Google-Suche. Für Bekleidung sind in Deutschland Farbe, Größe, Geschlecht und Altersgruppe Pflichtangaben, bei Varianten zusätzlich Merkmale wie Material oder Muster, wenn sie die Varianten unterscheiden. Gewicht und Maße sind optional.6 Wenn die Daten für den Produktfeed sowieso vorliegen, kannst du daraus auch einen ordentlichen Text für die Produktseite machen.
Dazu kommt die Bedienbarkeit. Hersteller-PDFs enthalten oft mehr als das eine Produkt, häufig stecken alle Varianten darin, eine ganze Serie oder gleich der Katalog. Deine Kundin hat im Shop das richtige Produkt gefunden, klickt auf das Datenblatt und darf sich die Werte für ihre Variante aus drölfzig anderen heraussuchen.
Im B2B ist es nicht anders. Technische Datenblätter sind dort oft schon ein halber Produktkatalog, und es gibt viele aufwendig gestaltete PDFs, in denen viel Mühe steckt. Sobald es aber um Inhalte geht, nach denen Kund:innen suchen oder die sie für ihre Entscheidung brauchen, gehören sie auch hier ins HTML.
Wie lesen Kund:innen PDFs auf dem Smartphone?
Mühsam. Auf dem Handy wird ein PDF erst komplett heruntergeladen, bevor du etwas siehst, während eine HTML-Seite so früh wie möglich die ersten Inhalte anzeigt. Bei schlechtem Empfang oder einem älteren Handy merkst du den Unterschied deutlich. Beim Vergrößern bricht der Text im PDF außerdem nicht um, du schiebst die Seite hin und her.2
Die Nielsen Norman Group, ein Forschungsinstitut für Nutzerfreundlichkeit, hat in Nutzertests dieselben Probleme beobachtet: winzige Schrift, ständiges Zoomen, fehlende Navigation und eine Zurück-Taste, die nicht wie gewohnt funktioniert. Auch die Kosten für mobiles Datenvolumen nennen die Forschenden.7 Der Artikel ist von 2020, an den Grundproblemen hat sich aus meiner Sicht nichts geändert.
Dazu kommen hausgemachte Ärgernisse. Ein Link heißt nur „Download“ und verrät nicht, was dahinter steckt. Oder das PDF öffnet sich nicht, sondern lädt sich ungefragt irgendwo ins Nirvana des Handys, und wer es lesen will, muss es erst wiederfinden. Höflich gegenüber dem Datenvolumen deiner Kund:innen ist das auch nicht.
Warum siehst du kaum, was im PDF passiert?
Mit Google Analytics 4 kannst du messen, wie oft jemand auf einen Link zu einem PDF klickt. Das Ereignis heißt file_download und wird beim Klick auf den Link ausgelöst.8 Was danach passiert, siehst du nicht. Ob jemand das PDF gelesen, nach drei Sekunden geschlossen oder bis Seite 40 gescrollt hat, bleibt offen.
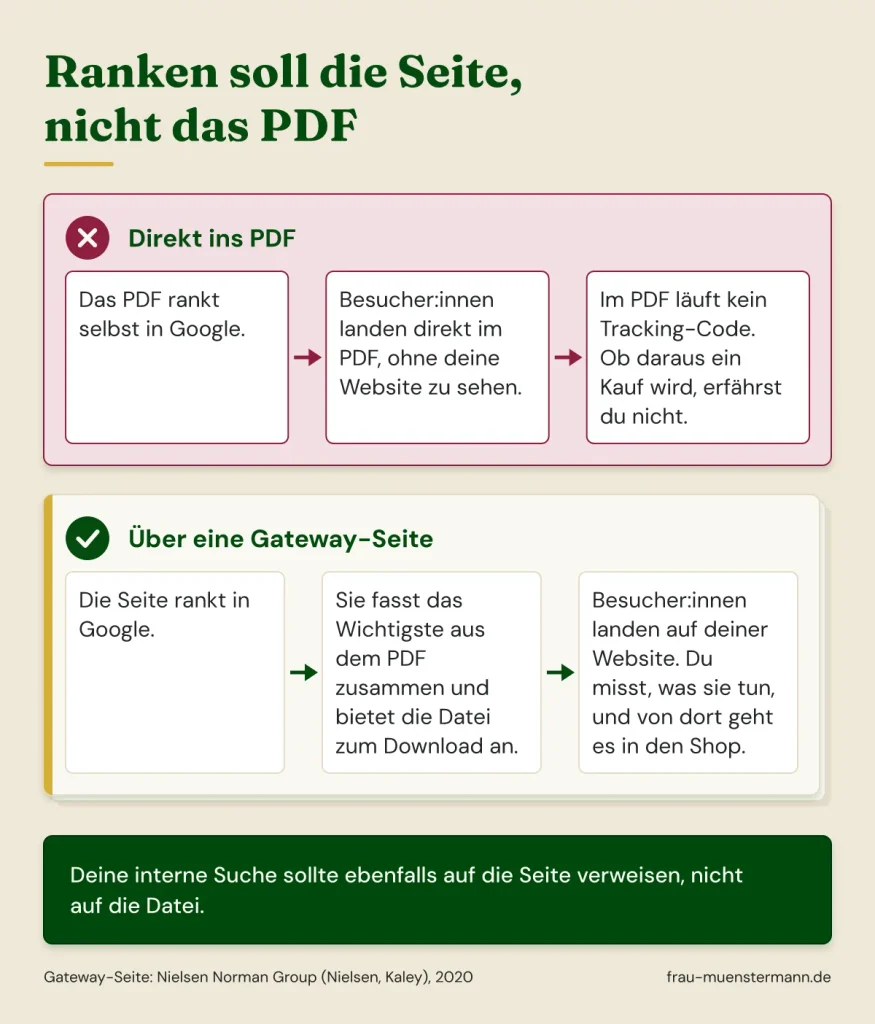
Noch schwieriger wird es, wenn das PDF selbst in Google rankt. Dann landet die Besucherin direkt im PDF, ohne deine Website zu sehen, und auf einem PDF läuft kein Tracking-Code. In der Search Console, Googles kostenlosem Werkzeug für Website-Betreiber, siehst du immerhin, wie oft das PDF in der Suche angezeigt und angeklickt wurde. Ob daraus ein Kauf wird, erfährst du nicht.
Wer hält das PDF aktuell?
Ein PDF ist schwerer zu ändern als eine Seite in deinem Shop-System. Ohne die Originaldatei oder ein spezielles Bearbeitungsprogramm musst du es komplett neu erzeugen.2 Dann steht schnell im Shop der neue Preis und im PDF noch der alte.
Google bemerkt Änderungen an PDFs außerdem langsamer, weil es sie seltener neu abruft (mehr dazu unten bei den Mythen). Mueller warnt vor allem vor PDFs, die ein CMS automatisch aus Webseiten erzeugt. Dann kann eine alte Fassung als PDF im Index stehen und eine neue als HTML-Seite, und beide konkurrieren mit unterschiedlichem Inhalt um dieselbe Suche.2
Jede zusätzliche Kopie ist eine zusätzliche Wahrheit, die jemand pflegen muss. Warum es für jede Art von Produktdaten genau ein führendes System braucht, habe ich im Artikel über die Single Source of Truth in deinem Shop beschrieben.
Was verlangt das Barrierefreiheitsgesetz?
Ich bin keine Juristin, deshalb ordne ich das nur ein. Seit dem 28. Juni 2025 gilt das Barrierefreiheitsstärkungsgesetz (BFSG) auch für Onlineshops, die an Verbraucher:innen verkaufen, eine Übergangsfrist für bestehende Shops gibt es nicht.9 Ausgenommen sind Kleinstunternehmen mit weniger als zehn Beschäftigten und höchstens 2 Millionen Euro Jahresumsatz oder Jahresbilanzsumme.10
Das Wort PDF kommt weder im Gesetz noch in der dazugehörigen Verordnung vor. Die Verordnung verlangt aber, dass Websites wahrnehmbar, bedienbar, verständlich und robust gestaltet sind und Informationen in Textformaten bereitstehen, aus denen sich andere Formate für Hilfsprogramme erzeugen lassen.11 Ein eingescanntes Datenblatt erfüllt das nicht.
Barrierefrei geht auch als PDF, aber es macht Arbeit. Überschriften, Lesereihenfolge und Alternativtexte für Bilder müssen im Dokument eigens hinterlegt werden, ein einfacher Export liefert das meist nicht.7 Auf einer Seite in deinem Shop pflegst du Überschriften und Bildbeschreibungen an derselben Stelle wie alles andere. Wie du ein PDF barrierefrei erstellst, ist ein eigenes Thema, dazu folgt ein eigener Artikel.
Welche Pflichten das BFSG für Shops mit sich bringt und warum du von sogenannten Overlay-Tools die Finger lassen solltest, steht in meinem Überblick über die Gesetze, die dein Shop heute erfüllen muss. Ob und wie das BFSG für deinen Betrieb gilt, lässt du im Zweifel anwaltlich prüfen.
Zwei Mythen, ein Rätsel und ein Fakt
Rund um PDFs halten sich ein paar Annahmen, die nicht stimmen. Eine Frage kann nicht einmal Google sicher beantworten, und eine verbreitete Annahme stimmt tatsächlich.
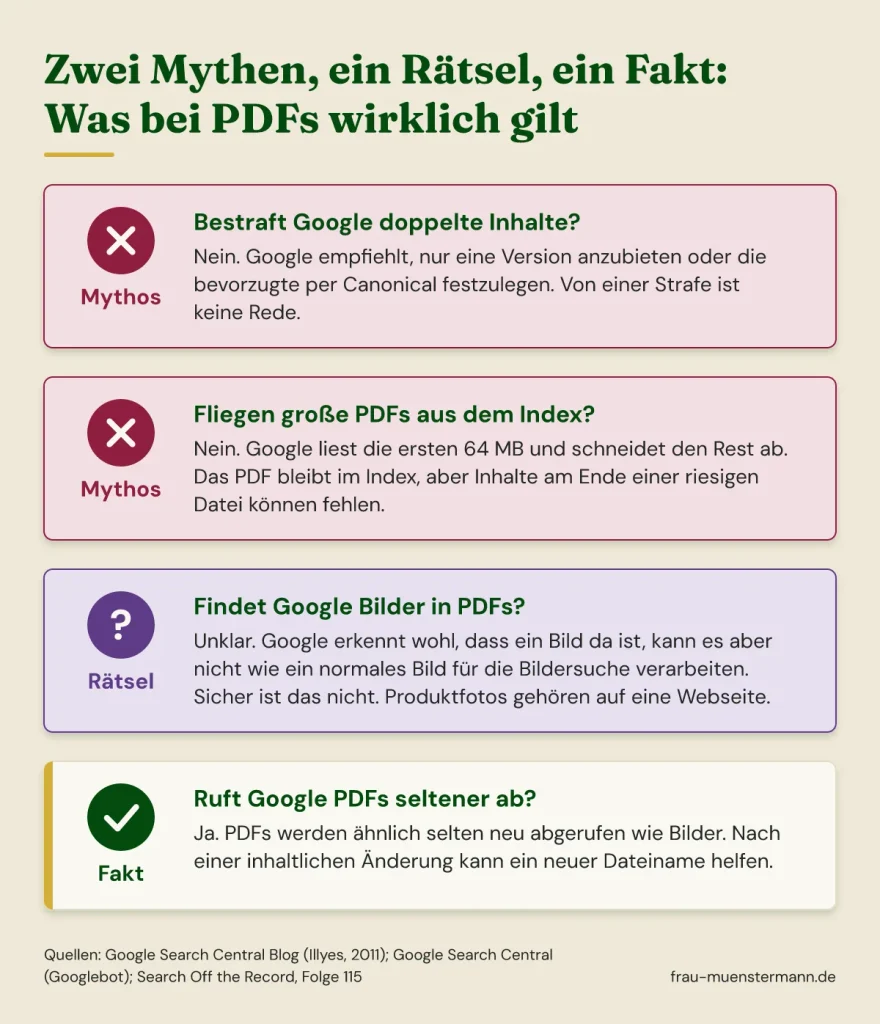
Bestraft Google doppelte Inhalte?
Ein Mythos. Wenn derselbe Inhalt als Webseite und als PDF vorliegt, empfiehlt Google, möglichst nur eine Version anzubieten oder die bevorzugte Version festzulegen. Von einer Strafe ist keine Rede.4
Festlegen kannst du das mit einem Canonical, einem Hinweis an Google, welche Adresse die maßgebliche ist. Bei PDFs gehört er in den HTTP-Header, also in die Zusatzinformationen, die der Server beim Ausliefern der Datei mitschickt.12 Das richtet dir die Person ein, die deinen Server oder dein Shop-System technisch betreut.
Kniffliger wird es, wenn andere Websites dein PDF herunterladen und selbst hochladen. Dann liegen exakt identische Dateien an mehreren Stellen, und Google kann schwerer erkennen, wo das Original liegt. Mueller rät deshalb, oben im PDF auf deine Website zu verlinken.2
Fliegen große PDFs aus dem Index?
Ebenfalls ein Mythos. Google liest bei PDFs die ersten 64 MB und schneidet den Rest ab.3 Das PDF verschwindet also nicht aus dem Index, aber Inhalte am Ende einer riesigen Datei können fehlen. Ein Katalog mit vielen hochaufgelösten Fotos erreicht diese Grenze eher als ein reines Textdokument.
Findet Google Bilder in PDFs?
Das ist das Rätsel. 2011 schrieb Google noch, dass Bilder in PDFs nicht indexiert werden.4 2026 sagt Splitt, Google erkenne wohl, dass ein Bild da ist, könne es aber nicht wie ein normales Bild für die Bildersuche verarbeiten, weil es keine eigene Adresse hat. Sicher ist er sich nicht, und das könne sich ändern.2 Wenn deine Produktfotos in der Google-Bildersuche erscheinen sollen, gehören sie auf eine Webseite.
Ruft Google PDFs seltener ab?
Ja, das ist der Fakt. Laut Mueller rufen Googles Systeme PDFs ähnlich selten neu ab wie Bilder, weil sie davon ausgehen, dass sich die Datei lange nicht ändert. Änderst du ein PDF inhaltlich, kann ein neuer Dateiname helfen, denn dann findet Google einen Link auf eine neue Adresse und ruft sie ab.2
Wann ist ein PDF die richtige Wahl?
Google nennt Formulare zum Ausfüllen und Dokumente, die gedruckt ganz bestimmt aussehen müssen.2 Bei Speisekarten ist Mueller pragmatisch: Ein PDF ist besser als gar keine Speisekarte, eine normale Webseite ist ihm aber lieber.2
Ich bin da strenger. Prospekte und Flyer haben ihre Berechtigung, aber offline, und da sollen sie auch bleiben. Fürs Netz gibt es HTML.
Eine Ausnahme sind für mich Zertifikate wie Prüfzeugnisse oder Konformitätserklärungen. Das Original darf als PDF bleiben, als Nachweis im unveränderten Layout. Welches Zertifikat nach welcher Norm vorliegt, gehört aber als Text auf die Produktseite.
Das häufigste Argument für das PDF lautet, dass Kund:innen es ausdrucken. Ich frage mich, wer ein Dokument noch ausdruckt, das er gerade auf dem Handy liest, zumal mit einem Dutzend Produktfotos in Farbe (Grüße an die Druckerpatrone). Und wer drucken will, kann das auch mit einer Webseite. Splitt weist darauf hin, dass sich in fast jedem Browser eine Seite als PDF speichern oder drucken lässt, Website-Betreiber müssen das also nicht selbst anbieten.2
Besonders schief wird es, wenn eine Agentur einen Flyer mit Wickelfalz gestaltet und genau diese Datei auf die Website wandert. Auf dem Handy liegt dann die Hälfte der Seiten quer, und lesen lässt sich das nur mit Verrenkungen.
Wenn du ohne PDF nicht auskommst
Manchmal muss es ein PDF sein, etwa bei einem Formular oder einem Dokument, das du genau so weitergeben musst. Dann helfen diese Punkte:
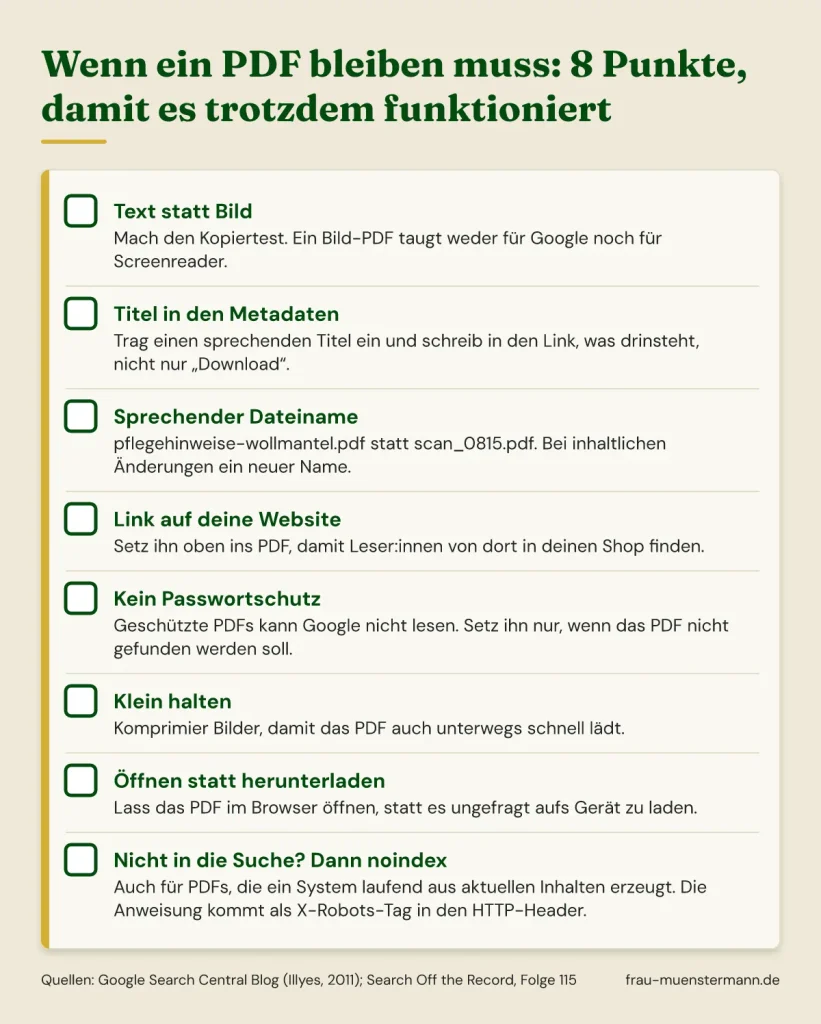
- Text statt Bild: Mach den Kopiertest von oben. Ein Bild-PDF taugt weder für Google noch für Screenreader.
- Titel in den Metadaten: Google bildet den Titel im Suchergebnis vor allem aus dem Titel in den Dokumenteigenschaften und aus dem Linktext, mit dem auf das PDF verlinkt wird.4 Trag einen sprechenden Titel ein und schreib in den Link, was drinsteht, statt nur „Download“.
- Sprechender Dateiname: Lieber pflegehinweise-wollmantel.pdf als scan_0815.pdf. Bei inhaltlichen Änderungen vergibst du einen neuen Dateinamen.
- Link auf deine Website: Setz ihn oben ins PDF, damit Leser:innen von dort in deinen Shop finden.2
- Kein Passwortschutz: Ein geschütztes PDF kann Google nicht lesen. Setz ihn nur, wenn das PDF nicht gefunden werden soll.4
- Klein halten: Komprimier Bilder, damit das PDF auch unterwegs schnell lädt.
- Öffnen statt herunterladen: Lass das PDF im Browser öffnen, statt es ungefragt aufs Gerät zu laden.
- Keine automatischen PDF-Kopien in die Suche: PDFs, die ein System laufend aus aktuellen Inhalten erzeugt, sollten nicht indexiert werden.2
- noindex, wenn es nicht in die Suche soll: Die Anweisung kommt als X-Robots-Tag in den HTTP-Header.4 Dass noindex per Header gesetzt auch für PDFs wirkt und wann du es einsetzen solltest, erkläre ich im Artikel zur Indexierbarkeit deiner Seiten.
Häng das PDF an eine Webseite
Jedes PDF, das bleiben muss, braucht eine Webseite, die es trägt. Die Nielsen Norman Group nennt das Gateway-Seite: Sie fasst das Wichtigste aus dem PDF zusammen und bietet die Datei zum Herunterladen an.7 Das muss keine eigene Seite sein. Bei Datenblättern, Anleitungen oder Zertifikaten reicht die Produktseite, auf der das PDF ordentlich verlinkt ist.
Ranken soll diese Seite, nicht das PDF. Auch deine interne Suche sollte auf die Seite verweisen statt auf die Datei.7 So landen Besucher:innen auf deiner Website, du kannst messen, was sie dort tun, und von da aus geht es weiter in den Shop.
Stehen auf der Seite und im PDF dieselben Inhalte, legst du die Seite per Canonical im HTTP-Header des PDFs als bevorzugte Version fest.12
Fang beim Prozess an, nicht bei der Liste
Bei hunderten Hersteller-PDFs liegt die Idee nahe, eine Prioritätenliste zu machen und jemanden die Daten nacheinander abtippen zu lassen. Davon halte ich nichts. Eine solche Liste brauchst du nur, wenn die Daten von Hand übertragen werden, und wer das ernsthaft plant, hat schon verloren.
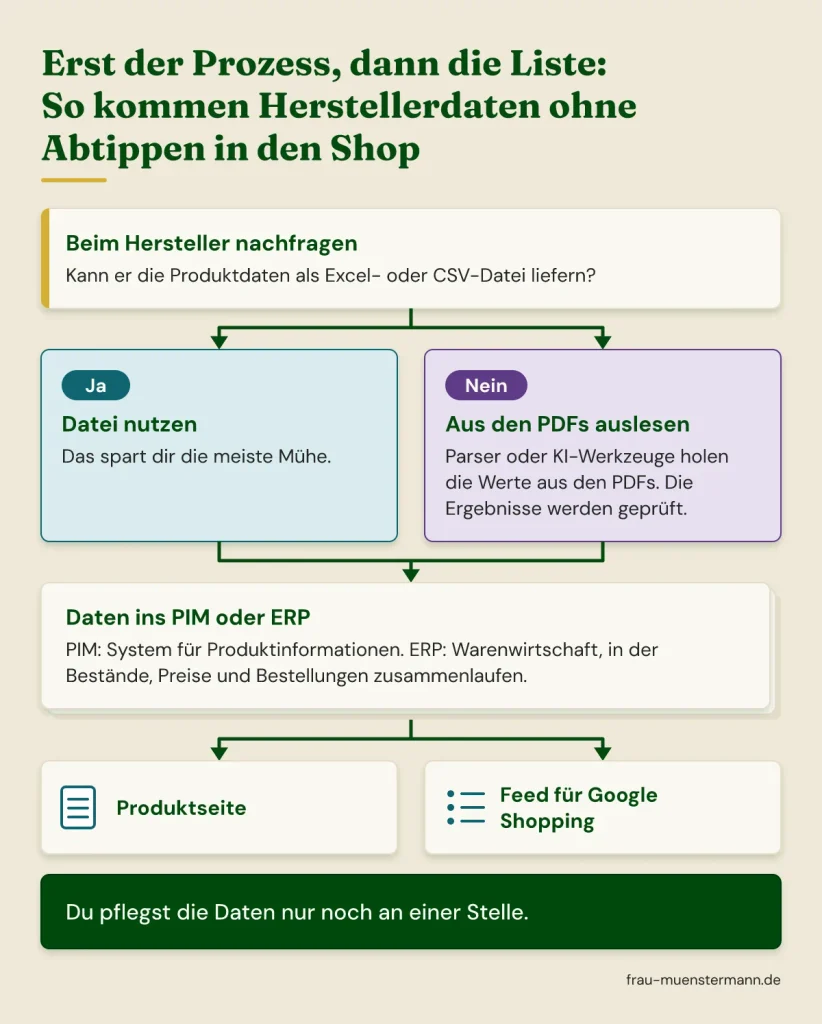
Frag zuerst beim Hersteller nach, ob er die Produktdaten als Excel- oder CSV-Datei liefern kann. Das spart dir die meiste Mühe. Wo das nicht geht, holen Parser, also Programme, die Daten aus Dokumenten auslesen, oder KI-Werkzeuge die Werte aus den PDFs. Das funktioniert gut, wenn sie richtig eingesetzt und die Ergebnisse geprüft werden.
Die Daten gehören dann ins PIM oder ins ERP. Ein PIM ist ein System für Produktinformationen, ein ERP die Warenwirtschaft, in der Bestände, Preise und Bestellungen zusammenlaufen. Von dort laufen die Daten auf die Produktseite und in den Feed für Google Shopping, und du pflegst sie nur noch an einer Stelle.
Wie viele PDFs Google von dir kennt, siehst du, wenn du in die Google-Suche site:deinedomain.de filetype:pdf eingibst. In der Search Console kannst du im Leistungsbericht außerdem nach Adressen filtern, die .pdf enthalten. Dort siehst du, welche PDFs schon Klicks aus der Suche bekommen und eine Seite brauchen, die sie trägt.
Fazit
Google kann PDFs lesen und zeigt sie in der Suche und in KI-Antworten. Für deine Kund:innen sind sie trotzdem fast immer die schlechtere Wahl: langsam auf dem Handy, mühsam zu durchsuchen, kaum messbar und schnell veraltet. Gehört ein Inhalt zu deinem Produkt oder deinem Angebot, gehört er auf eine Webseite.
Als nächsten Schritt suchst du mit site:deinedomain.de filetype:pdf nach deinen PDFs und schaust, von welchem Hersteller die meisten stammen. Schreib ihm eine kurze Mail und frag, ob er die Produktdaten als Excel- oder CSV-Datei liefern kann.
Welches PDF hat dich zuletzt auf dem Handy zur Verzweiflung gebracht? Erzähl es mir gern auf LinkedIn.
Quellen
- Google Search Central, „File types indexable by Google“, 2026: developers.google.com, File types indexable by Google ↩
- Google Search Central, Martin Splitt und John Mueller, „PDFs in Search: Indexing, AI & Pitfalls“, Search Off the Record, Folge 115, Transkript, 2026: search-off-the-record.libsyn.com, Transkript Folge 115 ↩
- Google Search Central, „Googlebot“, 2026: developers.google.com, Googlebot ↩
- Google Search Central Blog, Gary Illyes, „PDFs in Google-Suchergebnissen“, 2011: developers.google.com, PDFs in Google-Suchergebnissen ↩
- Mahe Chen und Nick Koudas, University of Toronto, „What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO)“, arXiv-Preprint, 2026: arxiv.org, What Drives AI Citations? ↩
- Google Merchant Center-Hilfe, „Product data specification“, o. J.: support.google.com, Product data specification ↩
- Nielsen Norman Group, Jakob Nielsen und Anna Kaley, „PDF: Still Unfit for Human Consumption, 20 Years Later“, 2020: nngroup.com, PDF: Still Unfit for Human Consumption ↩
- Google Analytics-Hilfe, „Enhanced measurement events“, o. J.: support.google.com, Enhanced measurement events ↩
- ChannelPartner, „Was die Pflicht zur digitalen Barrierefreiheit für Online-Shops und Kundenportale bedeutet“, 2025: channelpartner.de, Pflicht zur digitalen Barrierefreiheit ↩
- Bundesministerium der Justiz, „§ 2 BFSG, Begriffsbestimmungen“: gesetze-im-internet.de, § 2 BFSG ↩
- Bundesministerium der Justiz, „Verordnung über die Barrierefreiheitsanforderungen für Produkte und Dienstleistungen nach dem Barrierefreiheitsstärkungsgesetz (BFSGV)“, § 12: gesetze-im-internet.de, BFSGV ↩
- Google Search Central, „How to specify a canonical URL with rel=“canonical“ and other methods“, 2026: developers.google.com, Canonical-URL festlegen ↩